01
多模态感知
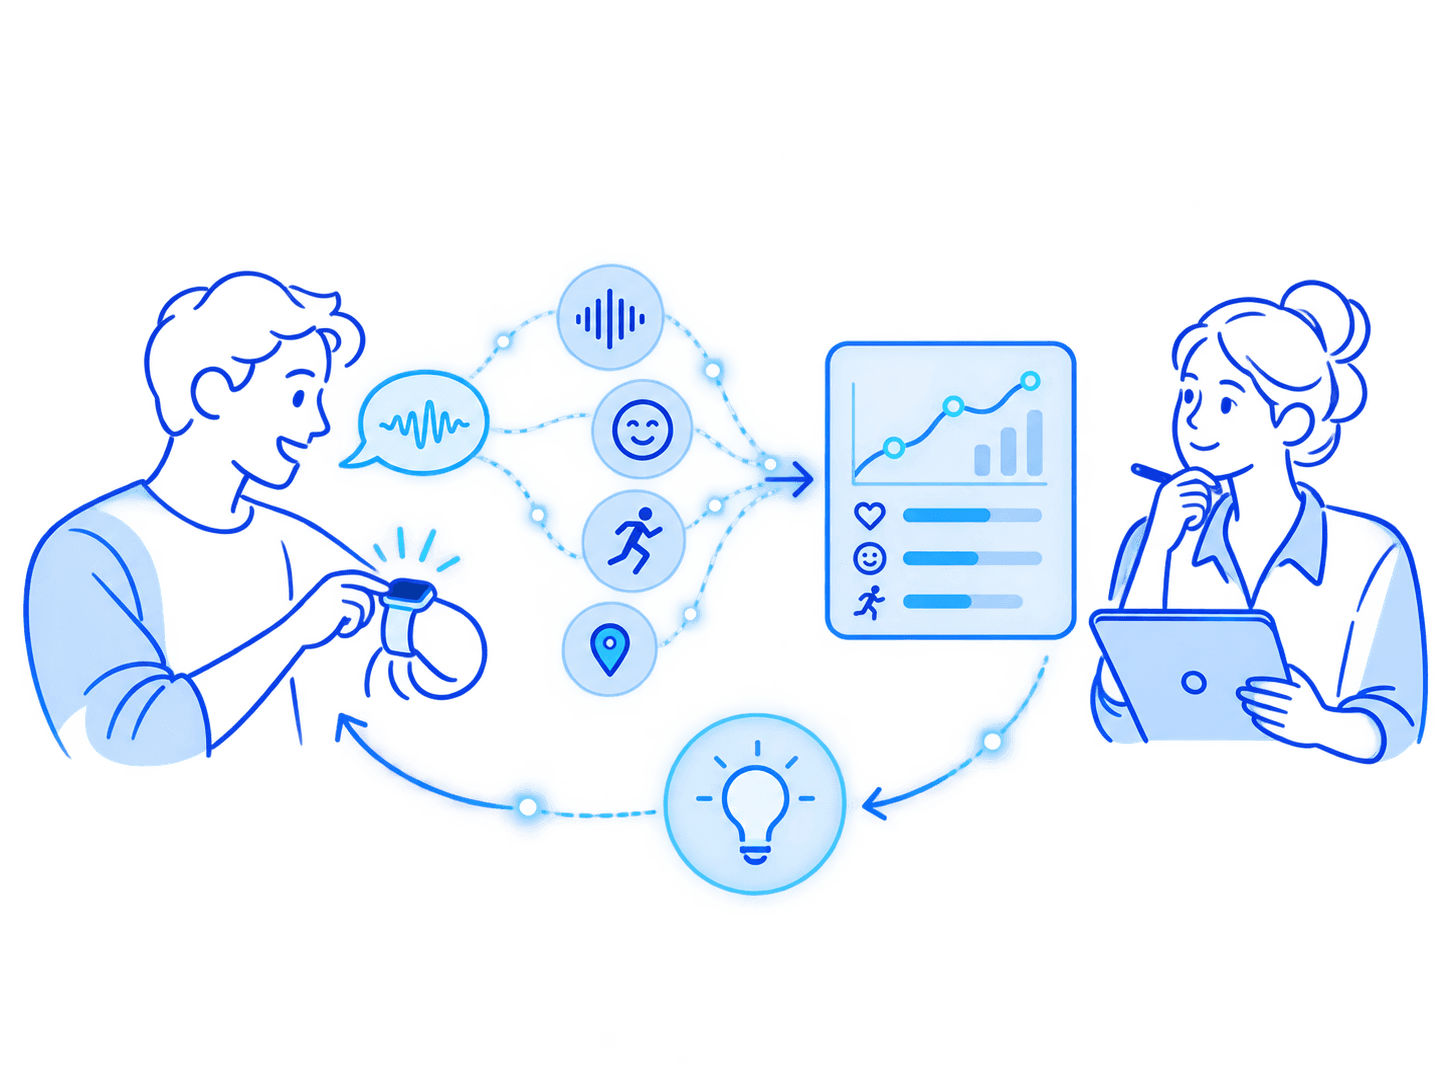
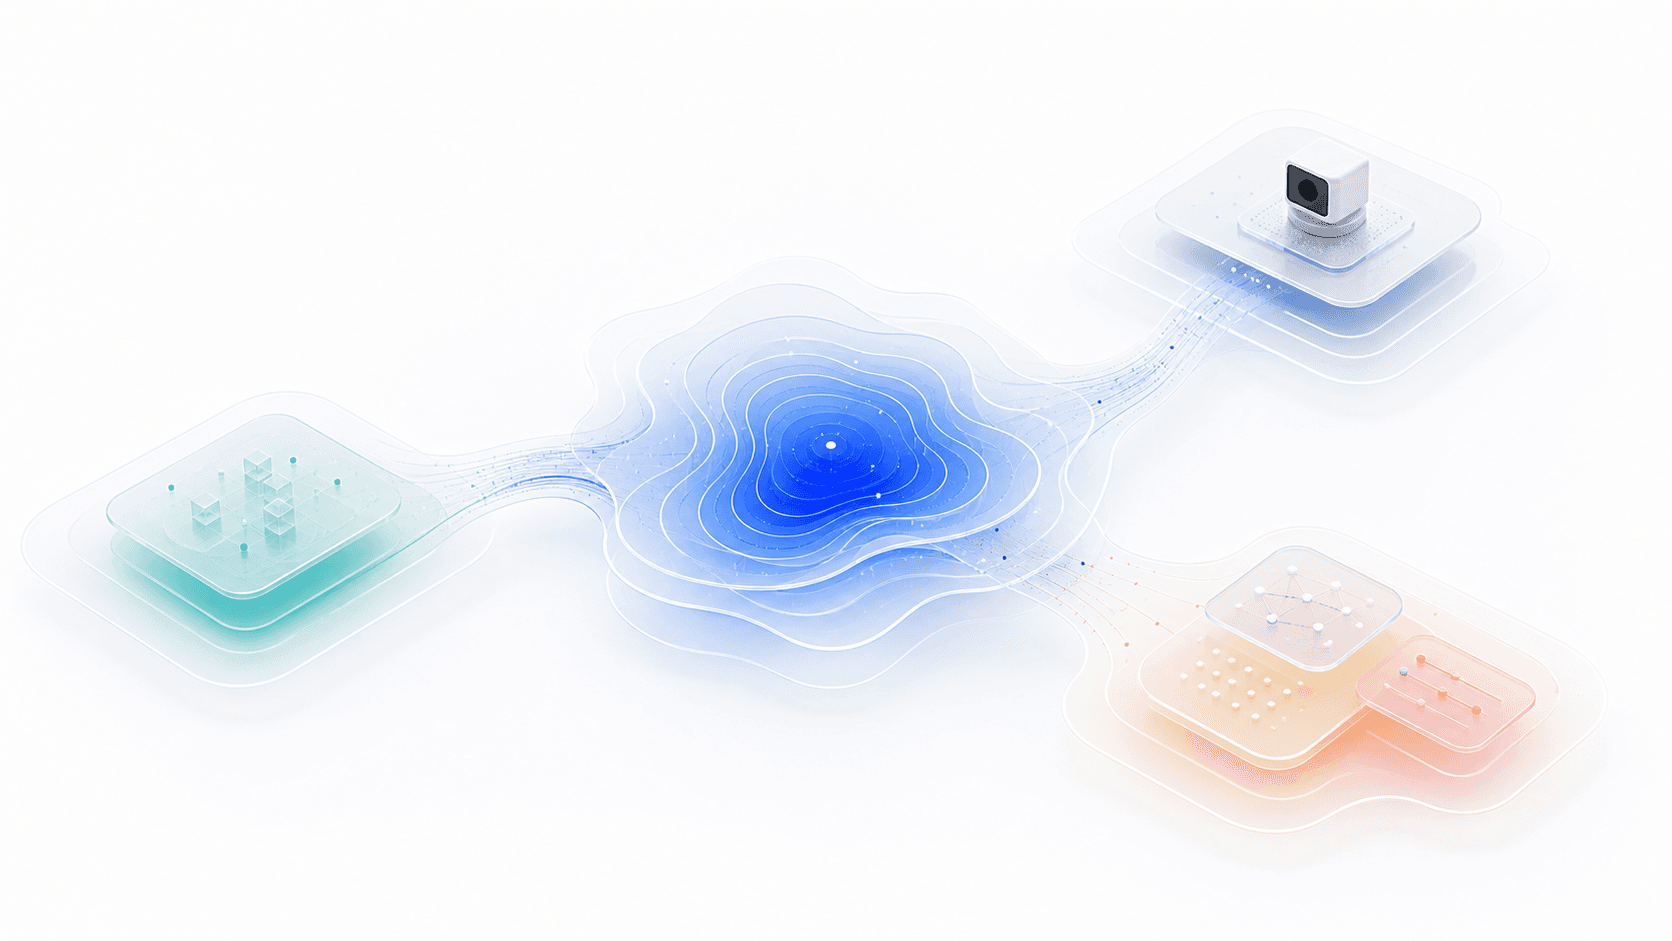
同时读取视觉、语音、生理、行为和环境信息,不用单一信号下结论。
01
感知
同时读取声音、画面和环境等信号。
理解
结合当时的情况,判断情绪和意图。
记忆
记住必要的偏好和过去的互动。
执行
把结果交给语言、界面或设备动作。
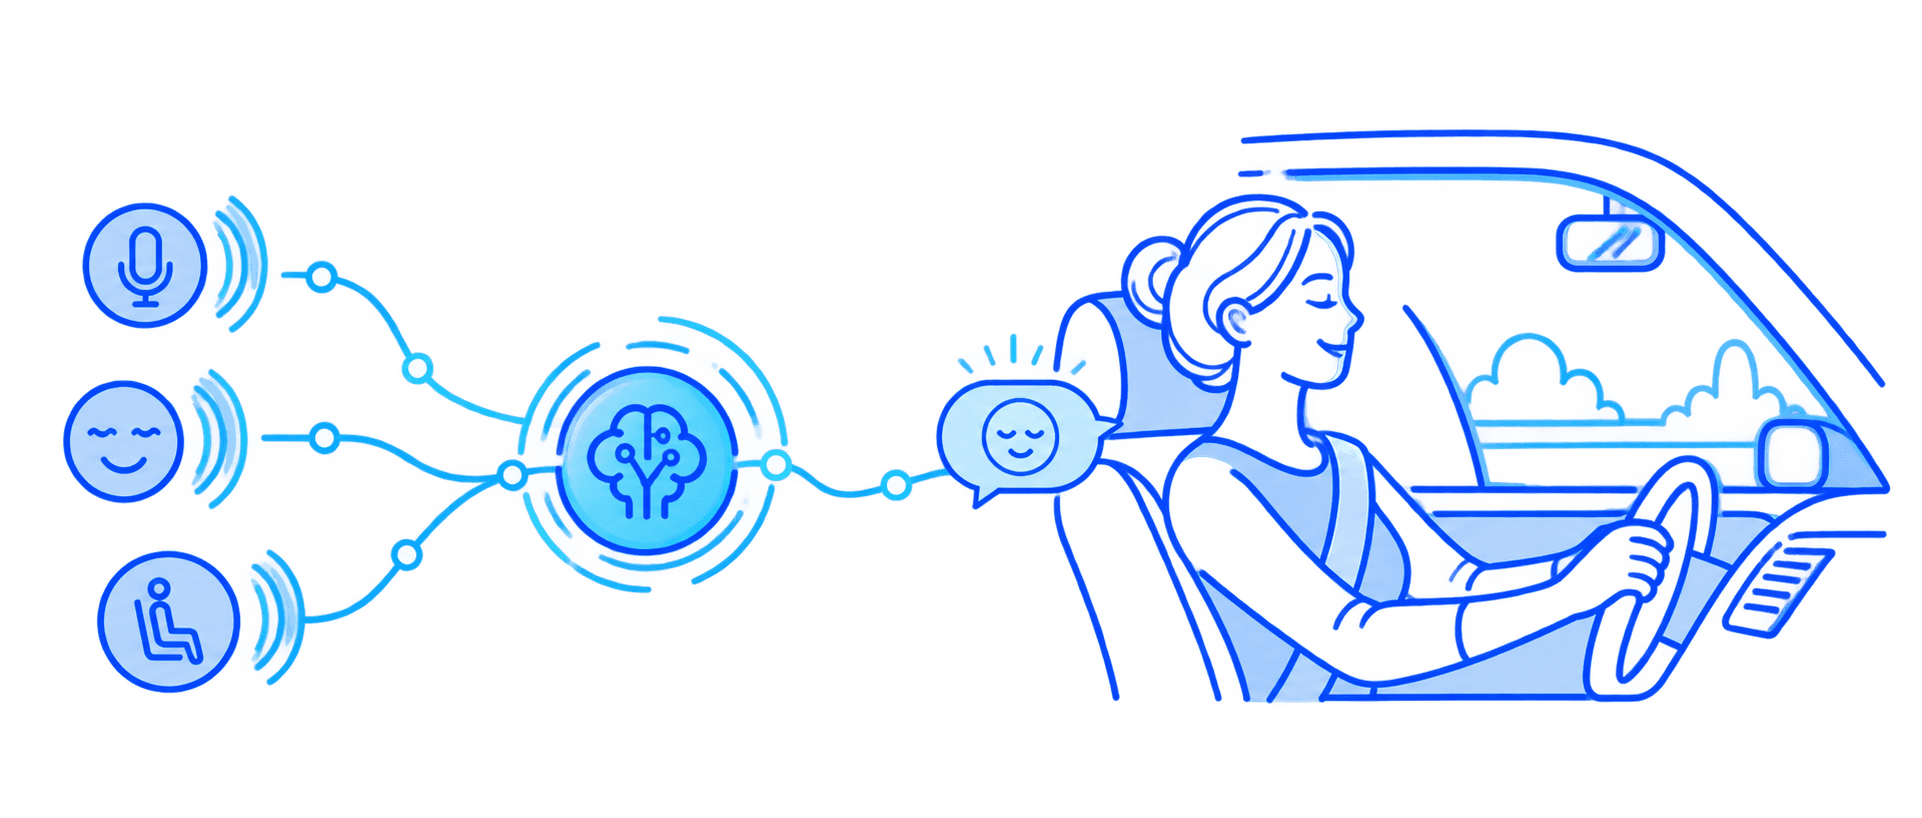
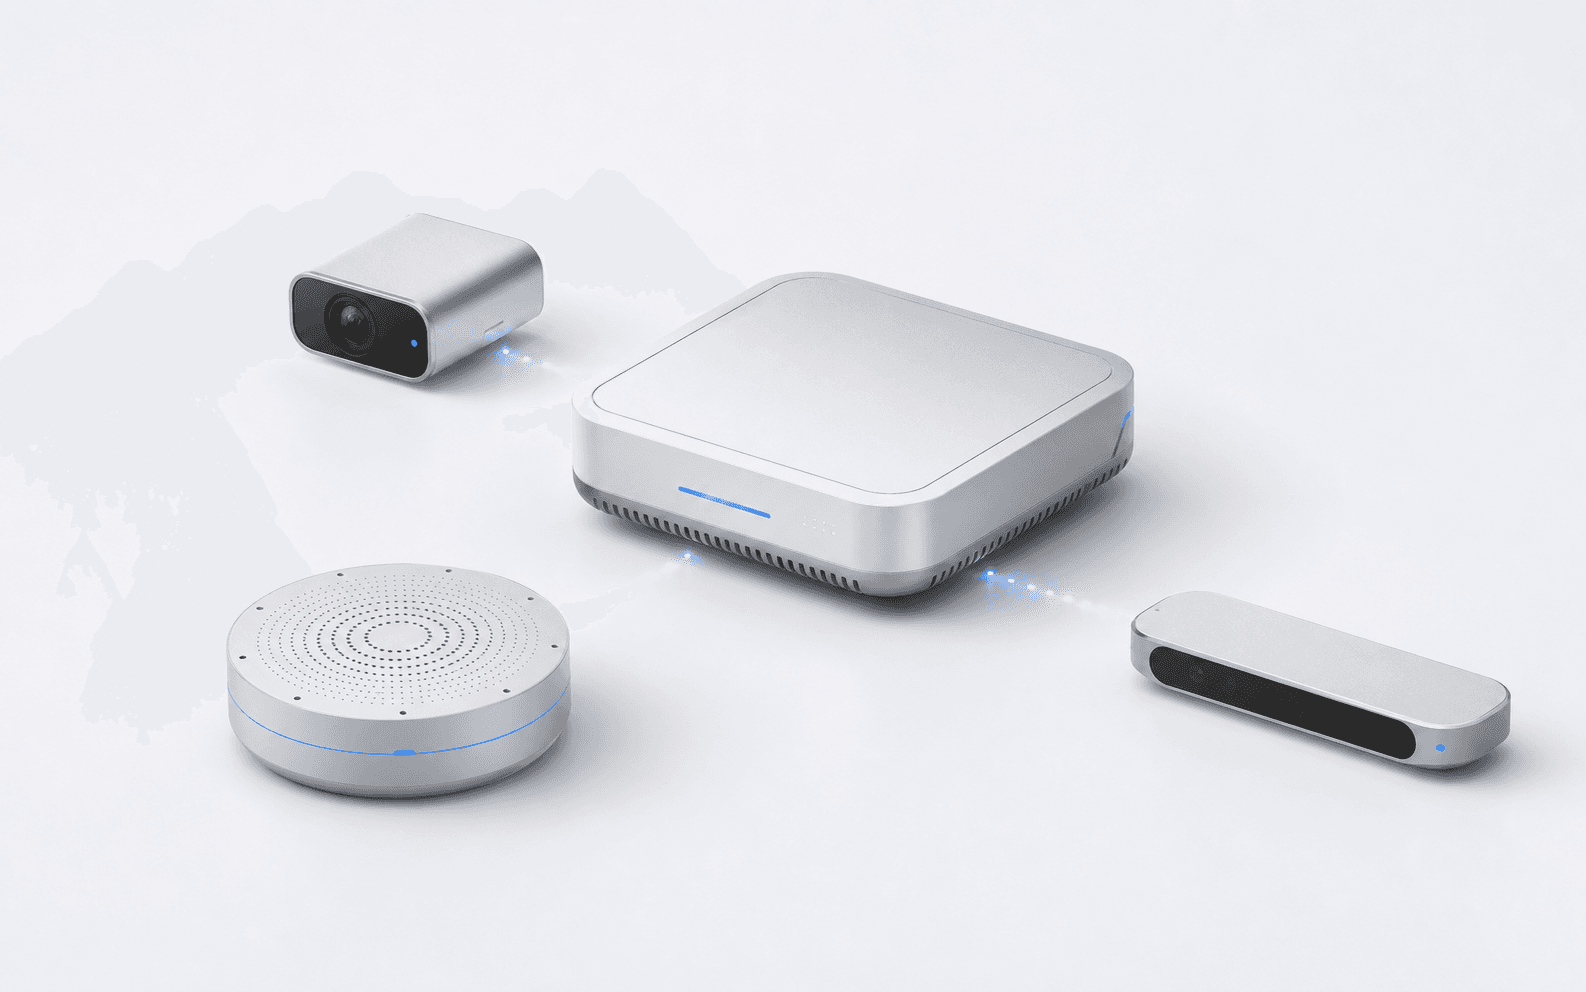
Finnox-V2.0 融合视频、音频、生理指标、场景和上下文,理解用户当下的情绪状态,并通过自我模型与情感世界模型分析意图和未来动作序列。
同时读取视觉、语音、生理、行为和环境信息,不用单一信号下结论。
结合多种线索理解当下状态和意图,并保留不确定之处。
在获得允许后,记住个人基线、偏好和此前的互动。
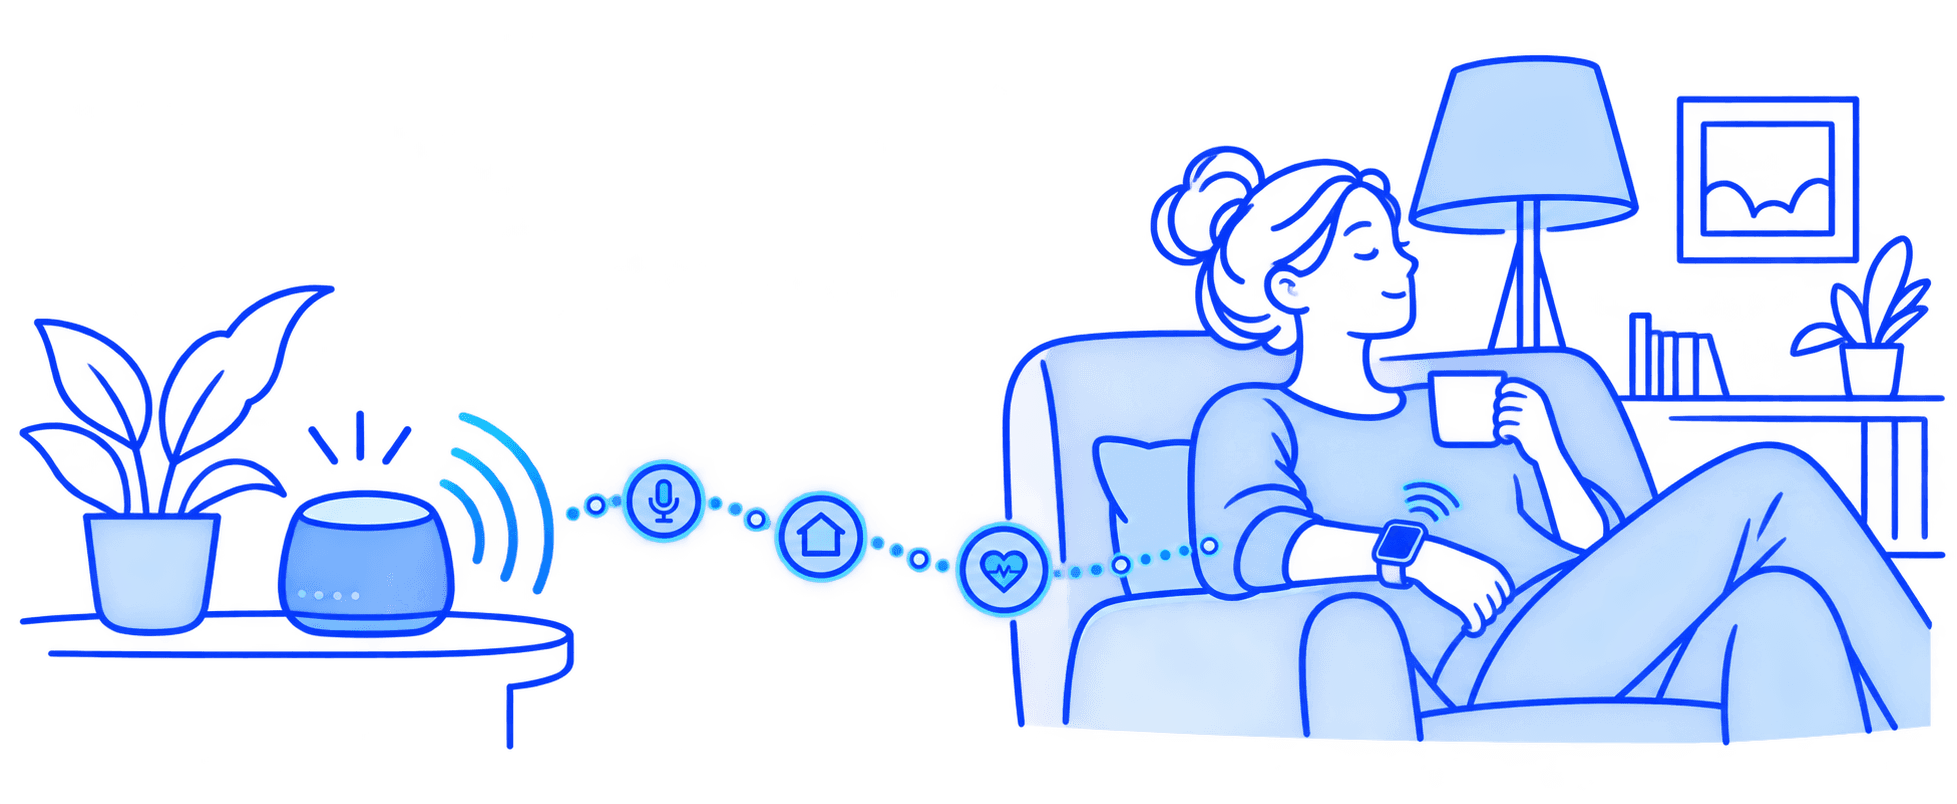
把结果交给语言、动作、提醒、灯光或界面等具体反馈。
提供 API 和开发工具,方便团队做原型并检查效果。
五个等级说明系统如何一步步形成感知、理解、预判、共情与适应能力
EI-L3 · 中学阶段
“幼儿园、小学、中学、大学”只用于类比认知能力的成熟过程,不对应真实儿童、学生的价值或智力,也不是对人的分级。